Магазин почти готов: дизайн принят, каталог загружен, на завтра назначен перенос на боевой домен. О поиске в такой момент вспоминают в последнюю очередь. Робот между тем может прийти уже в первые дни и запомнит сайт таким, каким его застал. Исправлять ошибки после этого долго: результата каждой правки ждут неделями, пока робот обойдёт страницы заново.
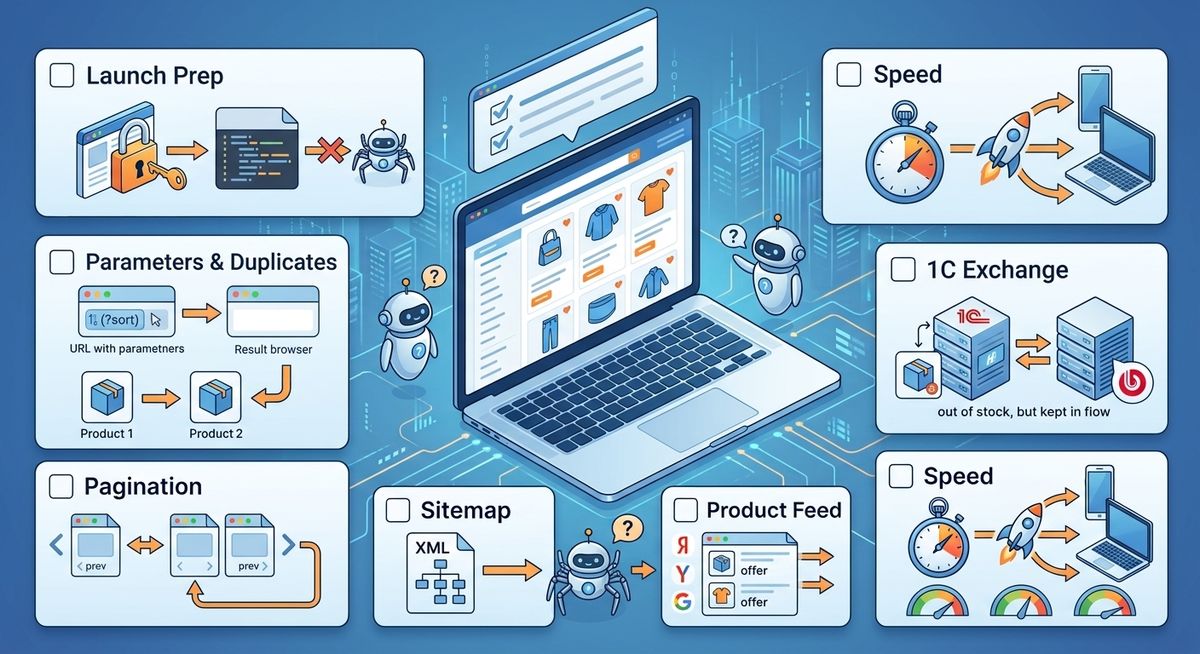
Большинство проверок перед запуском такие же простые: открыть код страницы и сверить с тем, что пишет о таком случае поисковик. Мы собрали их в один список в том порядке, в каком магазин движется к запуску: закрытая копия, дубли каталога, пагинация, карта сайта, товарный фид, обмен с 1С и скорость.
Закрытая копия и день запуска
Пока идёт разработка, копию сайта закрывают от роботов. Пароль на весь сайт надёжнее строки Disallow: / в robots.txt. Закрытый в robots.txt адрес может попасть в индекс Google по ссылкам с других сайтов и висеть в выдаче без описания. У Яндекса похожая оговорка есть про главную страницу, и для таких случаев он сам советует авторизацию.
В день переноса на боевой домен проверяют три места:
- в robots.txt снят общий запрет;
- в коде страниц нет мета-тега robots с noindex, и сам тег на странице один;
- веб-сервер не отдаёт заголовок X-Robots-Tag с запретом.
Отдельно посмотрите, где стоит счётчик Метрики. В Вебмастере есть настройка «Обход по счётчикам», и после её включения робот обходит все страницы со счётчиком. Справка Яндекса предупреждает, что так в поиск попадают корзина, страницы действий вроде добавления к сравнению и страницы с адресами и телефонами клиентов. Служебным страницам заранее запрещают индексирование, личные данные закрывают авторизацией.
Дубли каталога
Рекламные метки и параметры сортировки создают копии страниц. Яндексу их перечисляют в директиве Clean-param в robots.txt, и робот сводит такие адреса к одному. Google эту директиву не поддерживает: он понимает в robots.txt только user-agent, allow, disallow и sitemap. Для него на страницах с параметрами ставят canonical на адрес без параметров.
Сочетания фильтра делят на две группы. Те, у которых есть спрос и товары, оформляют как посадочные страницы со своим заголовком и текстом. Остальные либо закрывают в robots.txt, либо оставляют открытыми для робота и ставят на них noindex. Закрыть в robots.txt и одновременно поставить noindex нельзя: закрытую страницу робот не загружает и указаний на ней не видит.
У умного фильтра 1С-Битрикс есть свой дубль. Когда в фильтре ничего не выбрано, компонент собирает адрес со словом clear, например /catalog/obuv/filter/clear/apply/. Страница по нему показывает те же товары, что и сам раздел. Проверьте, что этот адрес закрыт или отдаёт canonical на раздел.
При включённом ЧПУ фильтра для списочных свойств в адрес идёт внешний код значения. Если коды не заданы осмысленно, в адресе окажется случайный набор букв и цифр. Привести коды в порядок нужно до запуска, пока на эти адреса никто не ссылается.
Товар, привязанный к нескольким разделам, открывается по нескольким адресам. В компоненте «Каталог» для этого есть параметр «Устанавливать канонический URL». Канонический адрес строится по основному разделу товара, а если он не задан – по разделу с наименьшим идентификатором. Проверьте, что параметр включён: в примере из документации он выключен.
Пагинация: Яндекс и Google отвечают по-разному
Google просит давать каждой странице списка свой адрес и свой канонический URL. Назначать первую страницу канонической для остальных он не советует, теги rel="next" и rel="prev" больше не использует. Его робот не нажимает кнопки и ходит только по ссылкам из href. Поэтому товары, которые открываются кнопкой «Показать ещё», должны быть доступны и по обычным ссылкам на следующие страницы.
Яндекс в блоге поддержки в конце 2015 года советовал ставить canonical со второй и следующих страниц на первую, если на них нет переходов из поиска, а содержимое во многом одинаково. В нынешней справке Вебмастера сказано другое: страницы пагинации могут индексироваться и участвовать в поиске без ограничений.
Мы советуем вариант, который отвечает обеим справкам: у каждой страницы списка свой canonical, номер страницы стоит в теге title, дубля первой страницы с параметром PAGEN_1=1 нет.
Карта сайта и robots.txt
В карте должны остаться только страницы, которые отдают код 200 и открыты для индексирования. После генерации проверьте её выборочно. По протоколу Sitemap один файл вмещает до 50 000 адресов и до 50 МБ без сжатия, большой каталог делят на несколько файлов. В 1С-Битрикс карту настраивают в разделе «Маркетинг», «Поисковая оптимизация», «Настройка sitemap.xml». На вкладке «Инфоблоки» у каждого инфоблока есть опция «Автогенерация», с ней карта обновляется сама при добавлении и удалении товаров.
Встроенный генератор robots.txt до сих пор предлагает поля «Главное зеркало (Host)» и «Интервал между запросами (Crawl-delay)». Заполнять их незачем: Яндекс не учитывает ни то, ни другое с 2018 года. Главное зеркало задают постраничным перенаправлением 301.
Товарный фид и разметка
Товарный фид готовят до запуска. В Яндексе его добавляют в бесплатном сервисе «Яндекс Товары»: раздел «Товары», вкладка «Источники данных», блок «Фиды». Проверка занимает до пяти рабочих дней, после неё товары могут показываться в поиске с фотографией, ценой и скидкой. У Google ту же роль играют Merchant Center и разметка Product на страницах.
Разметку FAQPage ради сниппета в Google закладывать незачем. Обычным сайтам он перестал показывать такие результаты ещё в 2023 году, а с 7 мая 2026 года убрал их совсем.
Обмен с 1С и скорость
Обмен с 1С может тихо убрать товар из поиска. Если закончившиеся позиции перестают попадать в выгрузку, сайт их выключает, они отдают 404 и теряют накопленные позиции. Такие товары оставляют в выгрузке и показывают с пометкой «нет в наличии». Заодно проверьте, что остаётся от описаний после обмена: выгрузка перезаписывает название и описание товара, и тексты контент-менеджера держат в отдельных свойствах.
Скорость проверяют на разделе каталога и на карточке товара: по главной о магазине судить трудно. Ориентиры Google для реальных посетителей: LCP до 2,5 секунды, INP до 200 миллисекунд, CLS до 0,1. Последний показатель чинится проще всех. На нашем сайте у обложек в списке статей не были заданы ширина и высота. Мы их проставили, и CLS на телефоне упал с 0,233 до 0,004.
Если магазин переезжает со старого сайта, каждому старому адресу нужен свой 301 на новую страницу. Во время разработки почти всё из этого списка занимает часы, после запуска каждая правка растягивается на недели. Поэтому перенаправления и базовую оптимизацию мы записываем в смету на разработку интернет-магазина на 1С-Битрикс отдельными строками ещё до начала работ.
С чего начать, если времени мало
Весь список за один вечер не пройти, поэтому вот порядок, в котором шли бы мы. Сначала запреты: robots.txt, мета-тег robots и заголовок сервера. Ошибка здесь либо прячет от поиска весь магазин, либо открывает лишнее. Потом дубли: параметры в адресах, пустой фильтр, товары в нескольких разделах. Затем карта сайта и перенаправления со старых адресов. Фид, разметку и скорость можно довести уже на работающем магазине: страниц от поиска они не закрывают.
Каждую проверку заканчивайте одинаково: откройте исходный код страницы и прочитайте, что в нём стоит. Наши два тега robots нашлись именно так.
Если времени нет и на это, есть два пути. Первый – отдать проверку перед запуском специалистам по продвижению, у которых такой список в ежедневной работе. Второй – подстраховаться автоматической проверкой: сервисом анализа сайта или одной из нейросетей, которой можно отдать адрес магазина и этот список. Замечания и рекомендации, которые они выдадут, проверьте вживую, в коде страниц и в справках поисковиков: нейросети тоже ошибаются.


Обсуждение
Войдите, чтобы оставить комментарий или задать вопрос.
Войти и написатьПока нет комментариев — будьте первым.